Ab 11. September läuft die CRA-Meldefrist: Ist Ihr Softwareteam bereit?
Am 11. September 2026 greifen die ersten zentralen Pflichten des EU Cyber Resilience Act. Die 24-Stunden-Frist macht Schwachstellenmanagement zur Frage des Betriebsmodells.
Kyluke McDougall
Software-Architekt & Gründer
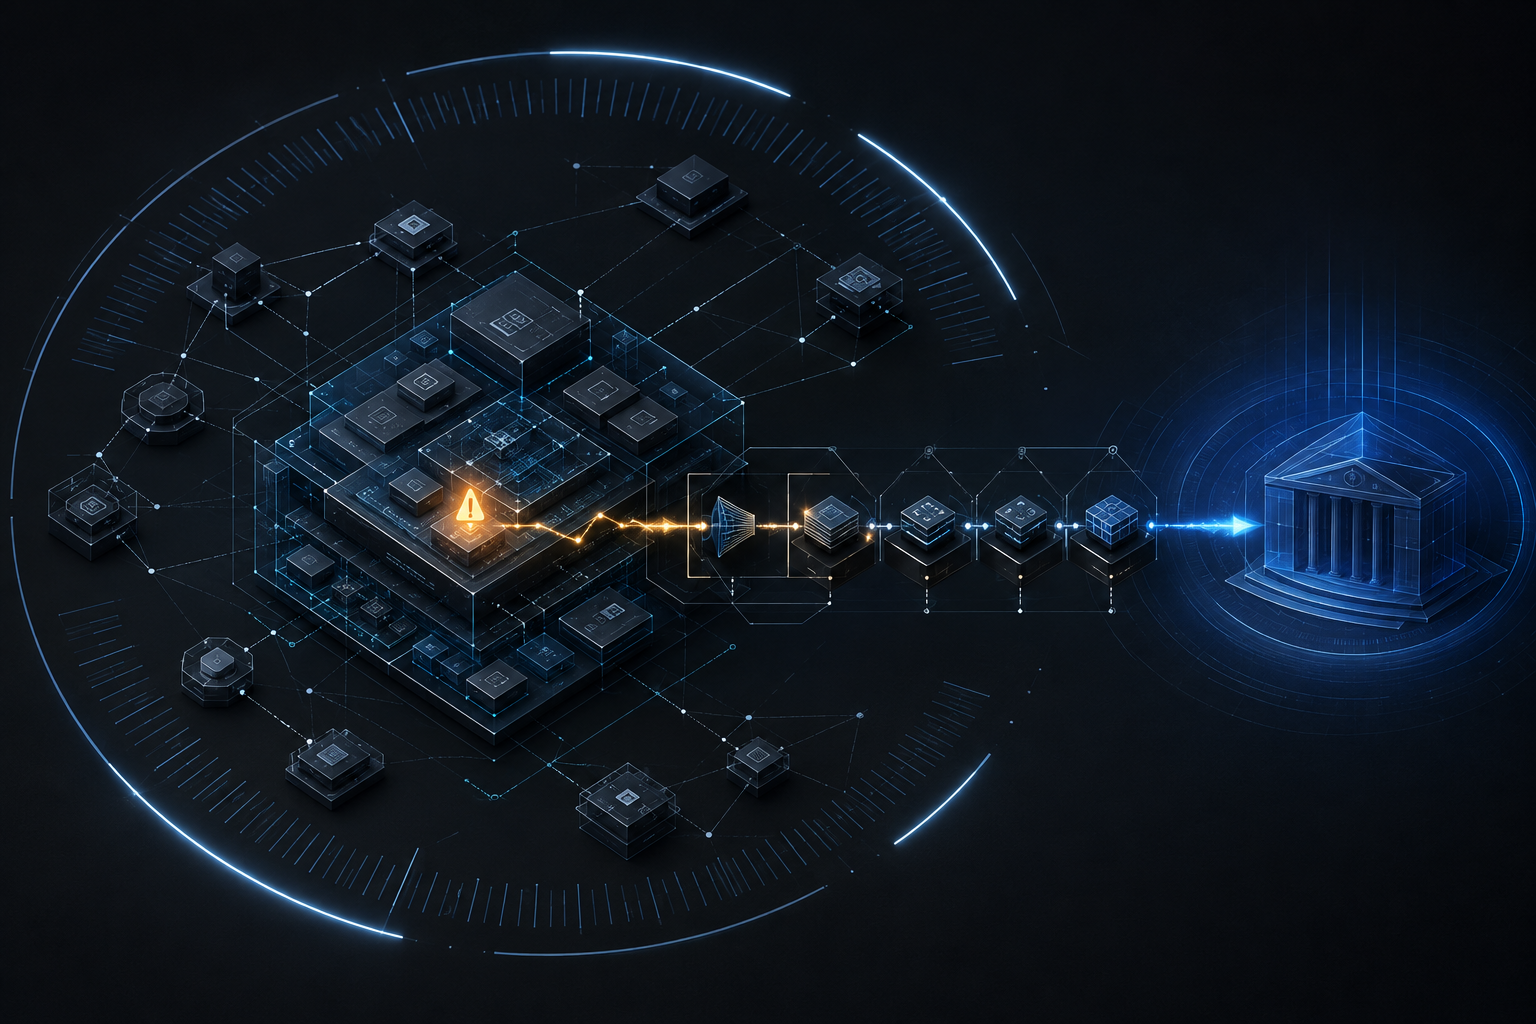
Am 11. September 2026 greifen die ersten zentralen Pflichten des EU Cyber Resilience Act.
Auf X rückt die Frist gerade bei Sicherheitsfachleuten, Embedded-Software-Unternehmen und Open-Source-Organisationen sichtbar in den Fokus. Das ist berechtigt: Hersteller von Produkten mit digitalen Elementen haben nach Kenntnis einer aktiv ausgenutzten Schwachstelle oder eines schwerwiegenden Sicherheitsvorfalls unter Umständen nur 24 Stunden Zeit für eine Frühwarnung.
Das klingt zunächst nach einem Problem für das Compliance-Formular.
Tatsächlich ist es ein Problem für Engineering und Betriebsmodell.
Wenn ein Team betroffene Produkte, Versionen, Kunden und Gegenmaßnahmen nicht schnell bestimmen kann, kann es unter Zeitdruck auch keine belastbare Meldung abgeben. Wenn die Verantwortung unklar ist, verschwinden 24 Stunden in internen Weiterleitungen, technischen Diskussionen und Management-Eskalationen.
Für Produktverantwortliche lautet die praktische Frage deshalb nicht nur: „Verstehen wir die Verordnung?“ Sie lautet:
Kann unsere Softwareorganisation das richtige Ereignis rechtzeitig erkennen, einordnen und eskalieren?
Was sich am 11. September 2026 ändert
Der Cyber Resilience Act, die Verordnung (EU) 2024/2847, gilt grundsätzlich für Produkte mit digitalen Elementen, die auf dem EU-Markt bereitgestellt werden und deren vorgesehene oder vernünftigerweise vorhersehbare Verwendung eine direkte oder indirekte Verbindung mit einem Gerät oder Netz einschließt.
Der Großteil der Verordnung gilt ab dem 11. Dezember 2027. Die Meldepflichten beginnen früher: am 11. September 2026.
Nach Artikel 14 müssen Hersteller melden:
- aktiv ausgenutzte Schwachstellen in einem Produkt mit digitalen Elementen; und
- schwerwiegende Vorfälle, die sich auf die Sicherheit eines solchen Produkts auswirken.
Für beide Kategorien ist unverzüglich, spätestens jedoch innerhalb von 24 Stunden nach Kenntnis des Ereignisses, eine Frühwarnung abzugeben. Soweit die relevanten Informationen noch nicht übermittelt wurden, folgt innerhalb von 72 Stunden eine ausführlichere Meldung.
Die späteren Fristen unterscheiden sich. Bei einer aktiv ausgenutzten Schwachstelle ist der Abschlussbericht spätestens 14 Tage nach Verfügbarkeit einer Korrektur- oder Minderungsmaßnahme fällig. Bei einem schwerwiegenden Vorfall ist der Abschlussbericht innerhalb eines Monats nach der Vorfallmeldung einzureichen.
Die Meldungen laufen über die zentrale EU-Meldeplattform an das zuständige koordinierende CSIRT und die ENISA.
Die Abgrenzung ist wichtig: Nicht jeder Bug, jeder Angriffsversuch und jede Serviceunterbrechung ist meldepflichtig. Die Verordnung definiert konkrete Schwellen. Teams brauchen einen Entscheidungsweg, der diese Fälle schnell und konsistent unterscheidet.
Dieser Beitrag ist eine technische Orientierung und keine Rechtsberatung. Ob ein konkretes Produkt oder Unternehmen in den Anwendungsbereich fällt, muss anhand von Produktmodell, Lieferkette und möglichen Ausnahmen fachkundig geprüft werden.
Das schwierigste Wort lautet „Kenntnis“
Die Meldefrist beginnt, sobald der Hersteller Kenntnis von der aktiv ausgenutzten Schwachstelle oder dem schwerwiegenden Vorfall hat.
Damit wird Kenntnis zu einer operativen Eigenschaft.
Ein Kunde meldet am Freitagnachmittag verdächtiges Verhalten beim Support. Ein Dependency-Scanner hat bereits Alarm ausgelöst, aber das Dashboard hat keinen klaren Owner. Ein Entwickler sieht passende Fehler in den Produktionslogs. Das Produktteam weiß noch nicht, ob eine aktive Ausnutzung vorliegt und welche Versionen betroffen sind.
Ab wann hat das Unternehmen Kenntnis? Wer darf diese Einordnung treffen? Wer sichert die Belege? Wer alarmiert Security und Rechtsberatung?
Ein Richtliniendokument beantwortet diese Fragen im Vorfall nicht, wenn der dahinterliegende Ablauf weder gestaltet noch geübt wurde.
Die Organisation braucht einen definierten Eingang für Signale aus:
- Kundenanfragen und Support;
- Meldungen von Sicherheitsforschern und Coordinated-Disclosure-Kanälen;
- Dependency- und Container-Scannern;
- Cloud-, Identity- und Endpoint-Warnungen;
- Anwendungslogs und Anomalieerkennung;
- Lieferanten, Maintainern und öffentlichen Schwachstellenquellen.
Jedes relevante Signal braucht einen Owner, einen Schweregradpfad und eine Eskalationszeit. Sonst ist „Kenntnis“ über Postfächer, Dashboards und individuelles Ermessen verteilt.
Die 24-Stunden-Frist hängt von der Produktarchitektur ab
Bei einer aktiv ausgenutzten Schwachstelle stellen sich vorhersehbare technische Fragen:
- Welche Produkte enthalten die betroffene Komponente?
- Welche Versionen und Deployments sind exponiert?
- Ist der verwundbare Pfad in der tatsächlichen Konfiguration erreichbar?
- Welche Kunden oder Märkte könnten betroffen sein?
- Lässt sich die Funktion deaktivieren, isolieren oder begrenzen?
- Gibt es einen Patch, und kann er sicher ausgerollt werden?
Das sind Architekturfragen, bevor es Meldefragen sind.
Ein gepflegtes Komponentenverzeichnis, eine Software Bill of Materials, ein Deployment-Inventar und eine klare Zuordnung der Verantwortlichen können die Analyse erheblich beschleunigen. Dokumente allein reichen jedoch nicht. Die Informationen müssen eine Abhängigkeit mit einem Produkt, das Produkt mit den ausgerollten Versionen und diese Versionen mit einem verantwortlichen Team verbinden.
Dasselbe gilt für Observability. Logs müssen sicherheitsrelevantes Verhalten sichtbar machen, ohne sensible Informationen offenzulegen. Deployment-Daten müssen zeigen, was tatsächlich läuft – nicht nur, was laut Repository laufen sollte. Feature Flags und Isolationsgrenzen sollten sichere Gegenmaßnahmen ermöglichen, wenn eine vollständige Lösung nicht sofort verfügbar ist.
Gute Architektur garantiert keine Compliance. Sie ermöglicht schnelle Entscheidungen auf Basis belastbarer Fakten.
Incident Response braucht eine eigene Meldespur
Viele Incident-Response-Pläne konzentrieren sich auf Eindämmung, Wiederherstellung und Kundenkommunikation. Der CRA ergänzt eine parallele regulatorische Spur.
Dafür braucht es klare Rollen:
- Technische Einsatzleitung: ermittelt Fakten, betroffene Versionen, Schweregrad und Stand der Gegenmaßnahmen.
- Product Owner: ordnet Produktnutzung, Kundenauswirkungen und betriebliche Folgen ein.
- Security- oder Compliance-Verantwortung: prüft die Meldeschwelle und koordiniert die Meldung.
- Entscheidungsverantwortung im Management: löst Entscheidungen mit großer Tragweite, ohne zum Engpass zu werden.
- Kommunikationsverantwortung: hält Kundenhinweise, technische Lage und regulatorische Meldung konsistent.
In einem kleinen Unternehmen kann eine Person mehrere Rollen übernehmen. Entscheidend ist nicht die Größe des Organigramms. Entscheidend ist, dass die Verantwortung vor dem Vorfall benannt ist.
Das Team sollte außerdem ein minimales Belegpaket vorbereiten:
- Produkt- und Versionskennungen;
- Zeitpunkt und Quelle der Entdeckung;
- aktuelle Einschätzung von Ausnutzung oder Vorfallschwere;
- betroffene Sicherheitsmerkmale und Geschäftsfunktionen;
- gegebenenfalls Länder, in denen das Produkt verfügbar ist;
- bereits umgesetzte Korrektur- oder Minderungsmaßnahmen;
- Maßnahmen, die Nutzer selbst ergreifen können;
- offene Fragen und die jeweils verantwortliche Person.
Für die erste Meldung ist keine vollständige Root-Cause-Analyse nötig. Auf Gewissheit zu warten, kann der größere Fehler sein. Der Ablauf muss eine korrekte Frühwarnung mit klar gekennzeichneten Unbekannten ermöglichen und später bessere Informationen nachliefern.
Fünf Bereitschaftschecks für jetzt
Wenige Tage vor dem Start sollten Teams die Kontrollen priorisieren, die überhaupt erst eine rechtzeitige Reaktion ermöglichen.
1. Anwendungsbereich und Verantwortung klären
Erstellen Sie eine Liste der Produkte mit digitalen Elementen, die auf dem EU-Markt bereitgestellt werden, des jeweiligen rechtlichen Herstellers sowie der verantwortlichen Produkt- und Security-Owner. Grenzfälle sollten mit qualifizierter Rechtsberatung geklärt werden, statt auf Annahmen zu beruhen.
2. Die Klassifizierungsentscheidung definieren
Übersetzen Sie die Schwellen aus Artikel 14 in einen kurzen Triage-Leitfaden. Nehmen Sie Beispiele für aktiv ausgenutzte Schwachstellen, schwerwiegende Sicherheitsvorfälle und Ereignisse unterhalb der Schwelle auf. Legen Sie fest, wer über die Meldung entscheidet und wer bei Abwesenheit übernimmt.
3. Technische Inventare verbinden
Testen Sie, ob das Team von einem verwundbaren Paket oder Bauteil zu betroffenen Produkten, ausgerollten Versionen und möglichen Kundenauswirkungen gelangt. Eine SBOM ohne Verbindung zur Produktionsrealität ist operativ unvollständig.
4. Den Meldeprozess vorbereiten
Prüfen Sie den Zugang zur Meldeplattform, die Daten des zuständigen koordinierenden CSIRT, interne Kontaktlisten und die Informationen für die Meldungen nach 24 und 72 Stunden. Zugangs- oder Freigabeprobleme sollten nicht erst im echten Vorfall auffallen.
5. Einen Tabletop-Test durchführen
Wählen Sie ein realistisches Szenario: eine ausgenutzte Abhängigkeit in einem kundenrelevanten Produkt, ein bösartiges Update oder einen Vorfall mit Auswirkungen auf Vertraulichkeit oder Integrität. Starten Sie die Uhr und beobachten Sie, wo der Prozess stockt. Beheben Sie zuerst diese Übergaben.
KI-gestützte Entwicklung erhöht den Bedarf an Nachvollziehbarkeit
KI-Coding-Tools können die Geschwindigkeit erhöhen, mit der Teams Softwarekomponenten einführen, aktualisieren und kombinieren. Sie können auch bei der Analyse von Abhängigkeitsgraphen, der Erstellung von Incident-Timelines, dem Vergleich betroffener Versionen und der Pflege der Dokumentation helfen.
Automatisierung hebt Verantwortung jedoch nicht auf.
KI-generierter Code braucht weiterhin Herkunftsnachweise. Vorgeschlagene Abhängigkeiten brauchen Verantwortliche. Von Agenten vorgenommene Änderungen brauchen Review- und Deployment-Protokolle. Ein KI-Assistent kann die Analyse beschleunigen, sollte aber weder unbeaufsichtigt die rechtliche Einordnung vornehmen noch regulatorische Meldungen versenden.
Das sinnvolle Muster ist kontrollierte Beschleunigung: Maschinen sammeln Belege und verkürzen die manuelle Suche; verantwortliche Menschen bewerten die Meldeschwelle und genehmigen die externe Meldung.
Die Frist zeigt, ob das Produkt wirklich betreibbar ist
Die CRA-Meldefrist ist eine Compliance-Anforderung. Sie legt aber auch etwas Grundsätzlicheres offen.
Eine Produktorganisation, die weiß, was sie betreibt, wer es verantwortet, wie es ausfallen kann und wie es sich absichern lässt, ist besser auf Kundenanforderungen, Audits und normale Vorfälle vorbereitet. Ein Team, das diese Fragen nicht innerhalb von 24 Stunden beantworten kann, hat bereits vor jeder regulatorischen Betrachtung ein Betriebsproblem.
Die stärkste Antwort auf den 11. September ist deshalb kein neues Dokument in einem Compliance-Ordner. Es ist ein getesteter Weg vom Signal zur Entscheidung:
erkennen, einordnen, eindämmen, belegen, melden und verbessern.
Dieser Weg gehört in Architektur und Betriebsmodell jedes ernsthaften digitalen Produkts.
Wenn Ihr Team CRA-Anforderungen in einen praktischen Product-Security-Prozess übersetzen muss, unterstützt McDougall Digital dabei, Architektur, Verantwortlichkeiten, Nachweise und Incident Response vor dem ersten echten Fristbeginn zusammenzuführen.
Dieser Beitrag wurde mit Unterstützung von KI erstellt. Verantwortlich für den Inhalt ist McDougall Digital.